作者:电子创新网张国斌
2026年的CIOE,如果只看光模块,会发现一个非常明显的变化:那就是光模块越来越不像一个独立产品,而越来越像AI算力基础设施中的一个“高速互联节点”。800G还在规模化爬坡,1.6T已经成为下一阶段竞争焦点,NPO、CPO开始从概念验证走向工程化讨论;与此同时,AI集群从几百颗GPU走向数千颗甚至更大规模,Scale-Up和Scale-Out网络对于带宽、时延、功耗以及可靠性的要求同步提高。
这意味着,过去藏在光模块内部、并不太被关注的DSP,正在被推到产业舞台中央。
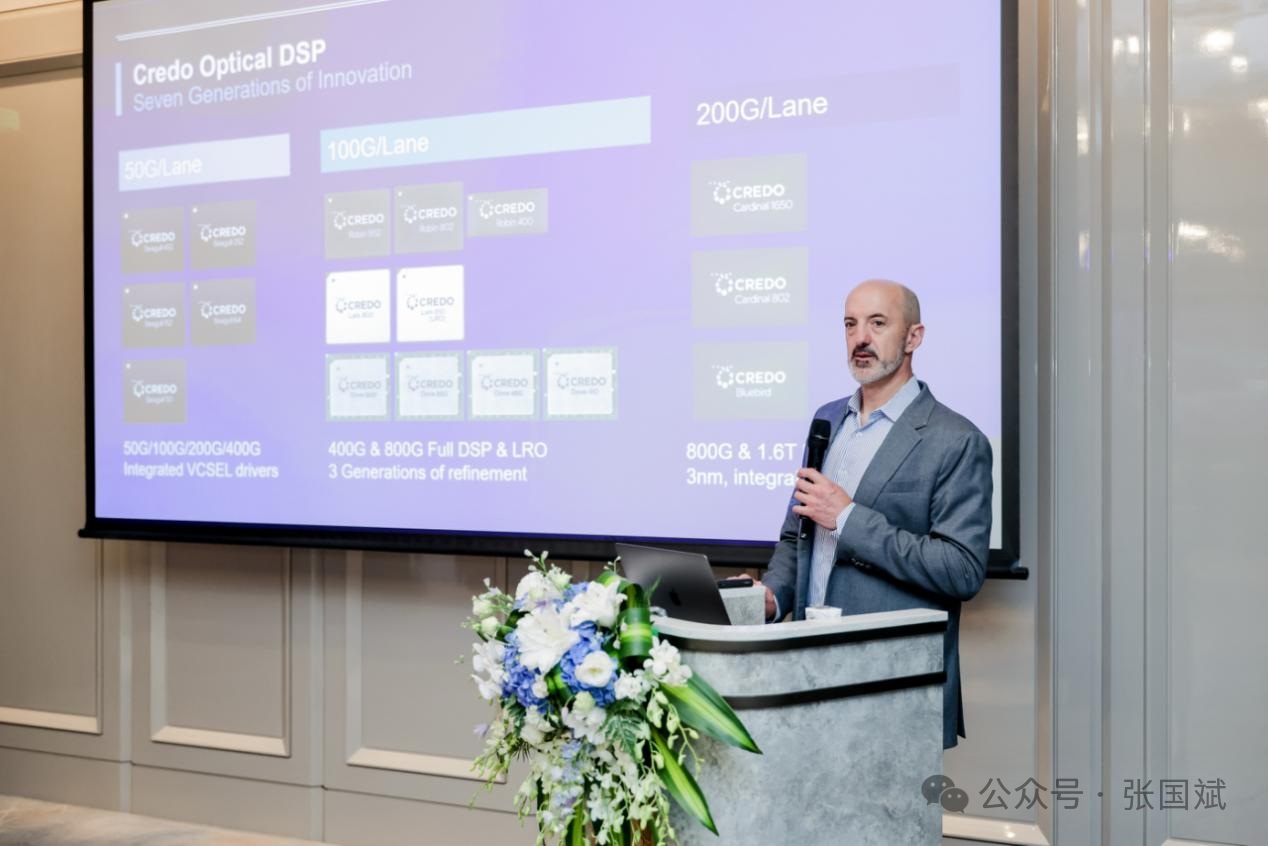
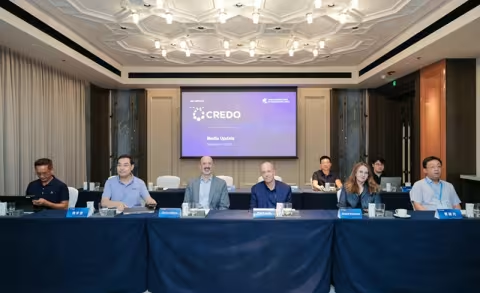
专注于高速连接解决方案的半导体公司有源电缆(AEC)发明者Credo在2026 CIOE前夕举办了一场媒体发布会,发布了新的DSP产品,Credo oDSP产品线负责人 Chris Collins 详细解读了光学数字信号处理器(optical DSP,oDSP) 完整产品家族。Credo 已经迭代七代 ODSP,覆盖 50G/lane、100G/lane、200G/lane 速率。针对当前行业普遍面临的供应挑战,Credo 的 Robin 800 系列则通过架构优化结合成熟工艺,实现与前代 Lark 产品相当的功耗与性能表现,更优的性价比。该DSP集成了EML 激光驱动器,封装尺寸进一步缩小,同时支持 Full DSP 与 LRO(线性接收光模块)两种架构,既有助于缓解上游供应链产能约束,也让客户对长期持续供货更有信心。
虽然在光博会上,很多厂商展示了去DSP的光模块方案,这类方案主要集中在 LPO(线性可插拔光学)、LRO(线性接收光学) 以及 NPO(近封装光学)等架构上,目的都是为了降低功耗和延迟的下一站,但DSP显然已经不只是“把电信号变成光信号”这么简单。
Collins表示面向 1.6T 时代,Credo 推出了Cardinal 系列oDSP。区别于行业普遍的8 通道单Die方案,Cardinal 系列提供 4 通道和8 通道两类 Die选项:Cardinal 802(4×200G)兼顾 800G、1.6T 两种场景;面向 LRO 路线,Credo分别推出 Cardinal 852(4 通道发射端)和Cardinal 1650(8 通道发射端),兼顾 800G 与 1.6T LRO 市场,给客户带来更高的设计灵活性。同时 Credo 正在积极推进其下一代448G/lane DSP技术,以满足未来高速互联的需求。
结合这次发布会,我们来谈谈光DSP未来七大发展趋势。
一、第一趋势:DSP继续向更高速率演进,但“堆速率”越来越难
过去几年,光通信DSP的主线非常清晰:100G/lane → 200G/lane → 400G/lane。而这条路线背后的核心逻辑,就是AI算力增长不断把网络带宽需求往上推。
当GPU数量从几十颗增加到数百、数千颗之后,网络已经不再只是“把GPU连起来”,而是直接影响整个AI集群的计算效率。
GPU等算力芯片越来越快,网络如果跟不上,就会出现新的“通信墙”。因此,DSP首先必须解决的,仍然是一个最基本的问题:如何在越来越高的单通道速率下,把信号完整地送到目的地。
但到了200G/lane甚至400G/lane,这已经不是简单提高SerDes速率那么容易。信号完整性、插损、串扰、抖动、器件非理想特性以及长距离传输带来的损耗都会急剧放大。这也是为什么Credo已经在推进448G/lane DSP技术。
所以未来DSP竞争的第一层,依然是:更高速率。但这只是第一关。
二、第二趋势:低功耗将成为DSP竞争的“生死线”
Collins表示AI数据中心最大的变化之一,是网络设备正在从“带宽优先”进入“带宽×功耗”的双重约束时代。以前增加一个高速光模块,大家首先关注的是:能不能跑起来?现在越来越多客户关心的是:每传输1 bit数据,到底要消耗多少能量?
原因很简单。当AI集群达到数万甚至更大规模的GPU以后,光模块数量、DSP数量、交换芯片数量都会成倍增加。单颗DSP多消耗几瓦,放到一个模块里可能并不起眼;但乘以几十万甚至百万级链路之后,就是非常可观的能源成本和散热压力。
因此,他表示DSP未来一定会进入一个“功耗精细化”的阶段。
这也是为什么我们看到行业开始出现更多关于:DSP架构优化、DSP与Driver集成、更先进封装、更高集成度、LPO/LRO以及硅光NPO/CPO的讨论。
以Credo此次推出的Robin 800系列为例,就强调通过架构优化和成熟工艺实现功耗、性能和成本之间的平衡,同时把EML激光驱动器集成进DSP,进一步缩小封装尺寸。
这说明一个趋势:DSP已经不再单纯追求“算得更快”,而是在追求“单位功耗下传得更多”。
三、第三趋势:DSP与硅光将从“两个产品”变成“一套系统”
这是2026 CIOE非常值得关注的一条主线。过去讲DSP和硅光,通常是两个产品:DSP负责电信号处理;PIC负责光信号调制、耦合和传输。但进入1.6T甚至更高速率时代,两者之间的耦合会越来越深。
因为当速率越来越高之后,DSP本身的能力已经无法脱离光学器件独立评价。DSP的算法、SerDes、驱动器、PIC、激光器、封装、散热,实际上已经形成一个完整的系统。
Credo此次特别强调的就是DSP与硅光并不是简单地“两个芯片叠加”,而是需要进行联合优化,包括oDSP、硅光PIC以及固件的联合调试。
这背后意味着一个很重要的产业变化:未来DSP厂商的竞争边界,会越来越靠近光学器件厂商。
谁只做DSP,可能会越来越难形成完整差异化;而拥有DSP+PIC+激光器+封装+固件能力的厂商,则有机会把整个链路一起优化。这也解释了为什么越来越多DSP公司开始向硅光延伸。
四、第四趋势:LPO不会简单“杀死”DSP,DSP反而会重新寻找自己的位置
2026 CIOE另一个非常热的话题,就是LPO。LPO最大的吸引力非常直接:把DSP拿掉。少一颗芯片,就意味着更低功耗、更低成本、更短链路延迟。所以过去一段时间,市场甚至出现过一种判断:LPO会不会让DSP成为“过渡性技术”
但这个判断可能过于简单。因为DSP之所以存在,并不仅仅是为了完成一个“电光转换”。
它真正的价值,是在高速信号传输过程中完成:均衡、FFE/DFE、CD/损伤补偿、抖动处理、长距离补偿、信号恢复等。
随着单lane速率不断提升,这些能力的重要性反而越来越高。
Chris Collins 对LPO的判断也非常明确:随着单通道速率提高,去掉DSP以后,均衡、器件损伤补偿和长通道补偿能力都会下降,因此LPO在不同链路场景下需要进行理性选择,LRO就是一种折中路线。
所以未来可能不是DSP vs LPO,二选一而更可能是:DSP、LPO、LRO、硅光、CPO根据不同链路场景重新分工。这其实也是2026年光通信产业越来越明显的趋势——技术路线开始从“谁替代谁”,转向“谁适合什么场景”。
五、第五趋势:DSP将从“信号处理”走向“链路感知”
这是笔者认为未来几年最值得关注、但目前容易被忽略的变化。传统DSP关注的是:信号能不能正常传输。而下一代DSP需要关注的则是:这条链路现在是什么状态?
AI集群最大的问题之一,是规模越来越大以后,链路故障的影响会被放大。一条链路出现问题,可能导致整个节点性能下降;更严重时,可能影响整个训练任务。因此,未来高速互联需要的不只是“高速”,还需要可观测性。
Chris Collins 表示Credo已经把这一能力放进ZeroFlap体系,通过DSP内部IP结合PILOT遥测软件,对光链路和电链路进行实时监测,并记录故障前状态,用于定位链路劣化和故障根因。“ZeroFlap 方案可以同时对光链路、电链路进行实时监测,提前预判链路劣化风险;即使发生突发链路故障,系统也可完整记录故障前链路状态,帮助运维人员定位根因,显著提升AI 集群互联可靠性,非常适合 Scale‑Up 纵向扩展 AI 集群场景。”他指出。
这意味着DSP的角色正在发生变化: 从“信号处理器”,变成“链路状态感知器”。如果进一步发展,未来DSP可能成为AI集群网络里的一个“传感器节点”。
它不仅知道数据有没有过去,还知道:为什么变差、什么时候会坏、哪一个器件正在老化。这会直接推动DSP从硬件芯片向“芯片+固件+软件+遥测”演进。
六、第六趋势:DSP的竞争将从单芯片竞争走向“系统级互联”
这可能是此次Credo最值得产业关注的信号。Chris Collins 表示Credo已经不再把自己定位成单纯的DSP厂商,而是提出“2.0系统级互联战略”,把SerDes IP、DSP、硅光、AEC、光模块以及链路监控整合起来。
这实际上反映了AI互联产业正在发生的一次结构性变化:客户真正需要的已经不是一颗DSP。客户需要的是: GPU/ASIC → SerDes → DSP → Driver → PIC → Laser → Optical Module → Cable → Switch → Monitoring
整条链路能够稳定、高效地跑起来。因此,未来DSP厂商的护城河很可能不再只是某一颗芯片的性能,而是:*能不能控制整个高速互联系统的关键环节。这也是为什么DSP行业正在出现越来越明显的垂直整合趋势。
七、第七趋势:DSP最终会进入“光互联+内存互联”更大的战场
如果说前面几个趋势还是传统光通信的延伸,那么Credo此次展示的OmniConnect/Weaver,则意味着DSP背后的技术能力正在向一个更大的市场扩展——AI内存互联。
今天AI推理越来越受到“内存墙”的限制。模型越来越大,参数和KV Cache越来越大,HBM虽然带宽极高,但容量和成本又成为新的约束。Credo提出通过LPDDR外接方式,在获得接近HBM带宽的同时获得更大的内存容量,为AI推理提供新的扩容路径。
这件事情真正值得关注的,并不是LPDDR本身。
而是:*高速互联正在从“GPU之间的数据搬运”,向“计算、内存、存储之间的数据搬运”扩张。换句话说,DSP背后的核心能力——高速SerDes、信号完整性、数据搬运、链路管理——正在进入更大的AI基础设施市场。
DSP真正的未来:不是一颗更快的DSP
如果把2026 CIOE的这些热点放在一起,会发现一个非常有意思的产业演进路径:100G/lane → 200G/lane → 400G/lane,解决的是速度;
DSP →LRO/LPO →硅光 →NPO/CPO;解决的是功耗和封装;
DSP+PIC+Driver+Firmware;解决的是系统协同;
DSP+Telemetry;解决的是可靠性;
DSP+Memory Interconnect--则开始解决AI基础设施的数据搬运问题。
所以,如果一定要给未来DSP下一个定义,我认为它已经不应该再被简单称为:“光模块里的DSP芯片”。更准确的说法应该是:DSP正在成为AI基础设施中的高速数据处理与互联控制节点。
而这也可能是2026 CIOE给光通信产业释放出的一个重要信号:AI时代真正稀缺的,不只是算力,而是把算力、内存和网络连接起来的能力。GPU负责“算”,光芯片负责“传”,而DSP越来越像那个连接两者的“中间层”。
未来,当AI集群进一步从Scale-Out走向更大规模的Scale-Up,甚至计算、内存、网络逐渐融合,DSP的战场也会从一个光模块,扩展到整个AI数据中心。这可能才是DSP产业真正值得关注的下一轮增长空间。
注:本文为原创文章,未经作者授权严禁转载或部分摘录切割使用,否则我们将保留侵权追诉的权利。